Um projeto pode ter milhões de estrelas e ainda assim fazer você passar a tarde depurando. O Slop Benchmark é uma forma direta de comparar um sinal visível de backlog e atividade: como os backlogs públicos de issues e pull requests se relacionam com as releases e o trabalho mesclado. Não é uma nota de qualidade de código, uma auditoria de segurança nem uma previsão de que um projeto vai fracassar. É um medidor rápido de pressão. Depois, lemos as issues abertas mais discutidas para ver como essa pressão aparece na prática.
O que o índice pode e não pode dizer
O retrato das pontuações foi coletado em 30 de outubro de 2026, das 17:27:15 às 17:29:31 UTC. As discussões das issues foram analisadas em 27 de outubro de 2026, e o status delas pode ter mudado desde então. A contagem de issues abertas exclui pull requests. Os registros de releases publicadas no GitHub incluem prereleases e excluem rascunhos. Os PRs abertos incluem rascunhos; os PRs fechados sem merge ficam registrados à parte e não entram no denominador.
A = issues abertas ÷ releases publicadas
B = (issues abertas + PRs abertos) ÷ PRs mesclados desde o início do projeto
C = (A + B) ÷ 2 quando há releases; caso contrário, C = B. Slop Log Score = log10(1 + C)
Quando não há releases, C é igual a B. Quando o número de PRs mesclados é zero, B e o Slop Log Score ficam como N/A, mesmo que A exista. N/A não é zero. Os cálculos usam razões sem arredondamento; A, B e C aparecem com duas casas decimais, e o Slop Log Score, com quatro. Pontuações menores indicam menos backlog público em relação a esses denominadores de atividade, não uma prova de qualidade ou confiabilidade do software. O ritmo de releases, a idade do projeto, o tipo de issue e as práticas dos colaboradores afetam o resultado. As estrelas não entram no cálculo.
Na verificação qualitativa, analisei as três threads de issues abertas mais comentadas de cada projeto, atualizadas desde 27 de abril de 2026, conforme a situação em 27 de outubro. Não são necessariamente as issues mais comentadas de todos os tempos. Comentários não equivalem a usuários afetados independentes, e os exemplos não formam uma auditoria completa. Uma issue pode ser um relato de bug, uma pergunta, uma solicitação de recurso ou uma issue de acompanhamento.
A tabela comparativa
Valores mais altos indicam mais backlog em relação às medidas de atividade deste retrato. As estrelas foram registradas em 27 de outubro. Siga os links dos repositórios para verificar a situação de cada projeto.
| Projeto | Estrelas no GitHub (27 out.) | Issues abertas | PRs abertos | PRs mesclados | Fechados sem merge | Releases | A | B | C | Slop Log Score |
|---|---|---|---|---|---|---|---|---|---|---|
| Hermes Agent | 257,719 | 17,785 | 34,297 | 19,872 | 54,069 | 44 | 404.20 | 2.62 | 203.41 | 2.3105 |
| Paperclip | 107,968 | 3,476 | 3,180 | 4,118 | 6,256 | 30 | 115.87 | 1.62 | 58.74 | 1.7763 |
| Happy | 24,354 | 669 | 420 | 163 | 229 | 16 | 41.81 | 6.68 | 24.25 | 1.4022 |
| Cindy | 7,392 | 1,882 | 440 | 3,686 | 397 | 77 | 24.44 | 0.63 | 12.54 | 1.1315 |
| NanoClaw | 31,035 | 293 | 739 | 878 | 1,615 | 13 | 22.54 | 1.18 | 11.86 | 1.1091 |
| OpenClaw | 393,209 | 5,033 | 2,866 | 65,847 | 55,081 | 277 | 18.17 | 0.12 | 9.14 | 1.0062 |
| Flowise (arquivado) | 55,531 | 701 | 340 | 1,820 | 612 | 85 | 8.25 | 0.57 | 4.41 | 0.7332 |
| AutoGen | 61,589 | 562 | 560 | 2,537 | 821 | 98 | 5.73 | 0.44 | 3.09 | 0.6116 |
| Microsoft Agent Framework | 14,342 | 617 | 224 | 3,973 | 1,313 | 129 | 4.78 | 0.21 | 2.50 | 0.5437 |
| ZeroClaw | 33,051 | 671 | 415 | 5,065 | 2,455 | 155 | 4.33 | 0.21 | 2.27 | 0.5148 |
| OpenHands | 92,015 | 579 | 574 | 8,275 | 3,841 | 156 | 3.71 | 0.14 | 1.93 | 0.4662 |
| Pydantic AI | 20,906 | 1,168 | 482 | 4,716 | 2,009 | 351 | 3.33 | 0.35 | 1.84 | 0.4531 |
| Mastra | 29,128 | 383 | 277 | 16,580 | 4,247 | 131 | 2.92 | 0.04 | 1.48 | 0.3948 |
| AutoGPT | 187,788 | 356 | 381 | 6,107 | 4,052 | 127 | 2.80 | 0.12 | 1.46 | 0.3913 |
| Dify | 159,723 | 482 | 661 | 15,585 | 4,022 | 171 | 2.82 | 0.07 | 1.45 | 0.3885 |
| Google ADK | 22,024 | 189 | 219 | 673 | 2,532 | 91 | 2.08 | 0.61 | 1.34 | 0.3695 |
| Goose | 55,827 | 363 | 169 | 6,413 | 2,542 | 158 | 2.30 | 0.08 | 1.19 | 0.3405 |
| CrewAI | 60,180 | 389 | 545 | 2,472 | 2,592 | 247 | 1.57 | 0.38 | 0.98 | 0.2959 |
| Agent Zero | 19,585 | 60 | 84 | 314 | 577 | 76 | 0.79 | 0.46 | 0.62 | 0.2106 |
| Langflow | 156,070 | 209 | 1,049 | 7,976 | 2,628 | 316 | 0.66 | 0.16 | 0.41 | 0.1491 |
| LangGraph | 43,998 | 367 | 150 | 4,114 | 1,879 | 590 | 0.62 | 0.13 | 0.37 | 0.1379 |
| Letta Code | 3,719 | 193 | 120 | 3,703 | 877 | 360 | 0.54 | 0.08 | 0.31 | 0.1174 |
| n8n | 208,798 | 331 | 860 | 24,305 | 6,464 | 877 | 0.38 | 0.05 | 0.21 | 0.0839 |
| OpenAI Agents SDK | 30,336 | 15 | 4 | 2,131 | 1,530 | 124 | 0.12 | 0.01 | 0.06 | 0.0273 |
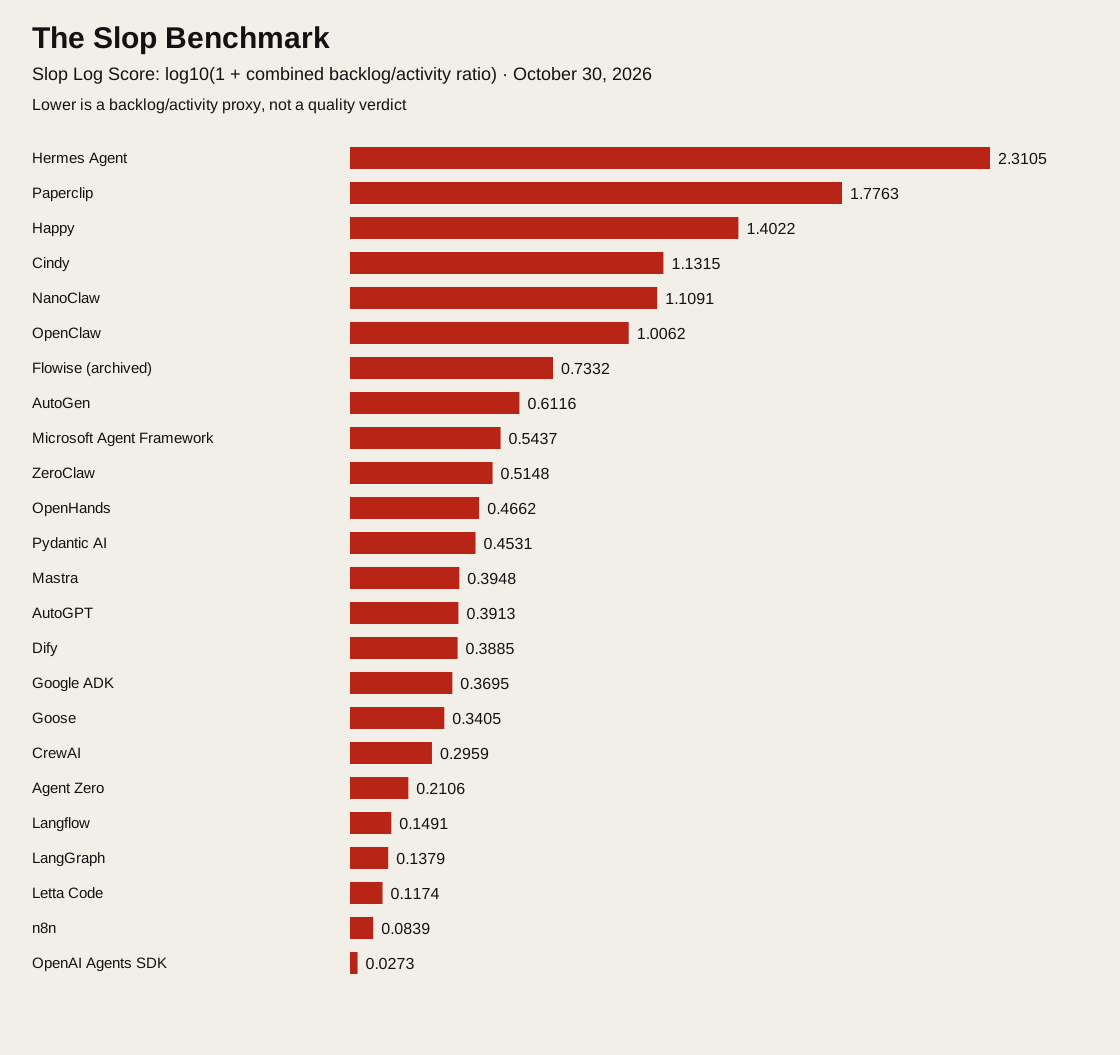
O gráfico do índice
O gráfico mostra os mesmos Slop Log Scores de 30 de outubro que aparecem na tabela. A tabela serve para a consulta exata, e as barras deixam a dispersão mais fácil de ver. Em telas estreitas, o gráfico fica na vertical para facilitar a leitura. Você também pode abrir o gráfico em tamanho real.

Estrelas vs. slop
As estrelas medem o hype, e o Slop Log Score mede a pressão do backlog. Com os dois no mesmo gráfico, dá para ver quais projetos são populares e ainda mantêm o backlog sob controle. A linha pontilhada de Pareto liga os repositórios que nenhum outro repositório supera nos dois critérios. A área verde marca estrelas acima da mediana com slop abaixo da mediana, e a área âmbar marca estrelas acima da média com slop abaixo da média; onde as duas se sobrepõem, o repositório passa nos dois critérios. As estrelas ficam no eixo vertical, em escala logarítmica (estrelas + 1), e continuam servindo de contexto, sem entrar no cálculo da pontuação.

Análise das issues, projeto por projeto
As discussões de issues abaixo foram analisadas em 27 de outubro. Elas formam uma amostra de triagem, não um veredito sobre mantenedores ou usuários; o status e os comentários das issues podem mudar.
Hermes Agent: Slop Log Score de 2.3105
Threads abertas mais comentadas nos últimos seis meses:
- Refatorar o godfile: dividir o catálogo de ferramentas de 2 mil tarefas em módulos fáceis de manter (#78647, 82 comentários)
- O app de desktop envia a mesma resposta do assistente duas vezes (#127665, 58 comentários)
- Abrir um pull request falha com erro de permissão (#131859, 53 comentários)
A thread mais discutida da amostra trata da divisão de um “godfile” enorme, o que sinaliza peso de manutenção, e não uma única falha em tempo de execução. Relatos mais concretos descrevem respostas duplicadas no app de desktop e erros de permissão ao abrir pull requests. Esses problemas afetam a capacidade do assistente de se comunicar e de terminar o trabalho. A refatoração em andamento é animadora, mas a popularidade não resolve esses defeitos. Teste as sessões no desktop e a criação de PRs em uma release fixada antes de depender do Hermes para tarefas sem supervisão.
Paperclip: Slop Log Score de 1.7763
Threads abertas mais comentadas nos últimos seis meses:
- Adicionar suporte ao Ollama como provedor de modelos (#187, 34 comentários)
- A passagem para o revisor pode ser pulada e não há nova tentativa (#13532, 26 comentários)
- O recovery hold pode entrar em deadlock silencioso ou duplicar o trabalho do watchdog (#14600, 23 comentários)
A issue mais comentada da amostra pede suporte ao Ollama; trata-se de um recurso ausente, não de um recurso quebrado. As threads seguintes preocupam mais: a passagem para o revisor pode ser pulada sem nova tentativa, e os recovery holds podem entrar em deadlock silencioso ou duplicar o trabalho do watchdog. Esses problemas atingem diretamente a coordenação de tarefas delegadas. Um coordenador que perde etapas de revisão ou trava sem avisar cria mais supervisão em vez de economizá-la.
Happy: Slop Log Score de 1.4022
Threads abertas mais comentadas nos últimos seis meses:
- Sessões do Codex travam enquanto aguardam mensagens (#358, 17 comentários)
- Adicionar suporte ao OpenCode (#265, 17 comentários)
- Celular e web não conseguem se conectar a uma sessão de terminal (#276, 15 comentários)
As threads da amostra trazem relatos de falhas: sessões do Codex travando enquanto aguardam mensagens e clientes de celular ou web que não conseguem se reconectar a sessões de terminal. As duas falhas comprometem o fluxo de trabalho entre dispositivos. A thread sobre suporte ao OpenCode é uma solicitação de recurso e não deve contar como prova de defeito. O Happy parece útil, mas inacabado, e não abandonado. Antes de adotá-lo, teste sessões longas, a recuperação de mensagens travadas e a reconexão em todos os dispositivos que você pretende usar.
Cindy: Slop Log Score de 1.1315
Threads abertas mais comentadas nos últimos seis meses:
- Esclarecer o escopo de recursos do Pi em relação a Claude/Codex e o contexto de projeto/usuário (#1991, 26 comentários)
- O app do Windows rouba o foco da janela em primeiro plano (#500, 16 comentários)
- Comprovar o bridge gate do Cindy (#3771, 11 comentários)
A principal discussão da amostra trata do escopo inconsistente de recursos entre Pi, Claude e Codex, incluindo o contexto de projeto versus o de usuário. Os comentários relatam parte do trabalho concluída ao lado de hooks de extensão incompletos, o que sugere desenvolvimento ativo com dívida de integração ainda pendente. Outras threads descrevem o roubo de foco no Windows e pedem a verificação do bridge gate. São problemas diferentes: acabamento do app de desktop, semântica dos provedores e confiança na fronteira entre componentes. Valide o escopo de contexto, o comportamento das extensões e as interrupções no desktop com os provedores exatos que você usa antes de tratá-lo como infraestrutura compartilhada confiável.
NanoClaw: Slop Log Score de 1.1091
Threads abertas mais comentadas nos últimos seis meses:
- Erro de certificado TLS no site (#1503, 19 comentários)
- Suporte a endpoints personalizados compatíveis com a OpenAI, incluindo Codex e OpenCode (#1984, 6 comentários)
- A atualização de habilidades quebra adaptadores de modelos locais (#3529, 5 comentários)
A thread mais comentada da amostra trata de um erro de certificado TLS no site, o que atrapalha a chegada de novos usuários, mas não comprova um defeito em tempo de execução. Outra pede endpoints personalizados compatíveis com a OpenAI; de novo, é uma funcionalidade ausente. O relato mais relevante para a confiabilidade diz que a atualização de habilidades quebra adaptadores de modelos locais. Isso pode derrubar uma instalação que funcionava bem depois de um upgrade. As discussões da amostra trazem evidências mistas, com pouca discussão sobre defeitos centrais. Teste a atualização dos adaptadores e a compatibilidade com os provedores, e mantenha uma versão que você sabe que funciona ao atualizar implantações.
OpenClaw: Slop Log Score de 1.0062
Threads abertas mais comentadas nos últimos seis meses:
- O trabalho de voz em tempo real acumula estado sem limite (#116201, 59 comentários)
- O Gateway trava por minutos ao copiar um plugin grande (#160959, 57 comentários)
- Issue de acompanhamento de desempenho e estabilidade da Web UI (#149361, 51 comentários)
As issues da amostra descrevem falhas com consequências reais. Um relato sobre voz em tempo real aponta estado crescente e buffers grandes demais. Outro relata travamentos de minutos no Gateway ao copiar um plugin grande, incluindo uma reprodução com uma extensão de 878 MB. Uma issue guarda-chuva da Web UI acompanha problemas de desempenho e estabilidade. Esses relatos são alertas operacionais relevantes. O volume de releases do projeto não deve ser confundido com confiabilidade. Faça testes de estresse com sessões longas de voz, instalação de extensões e responsividade da interface antes de permitir trabalho sem supervisão em um servidor permanente.
Flowise: Slop Log Score de 0.7332
Threads abertas mais comentadas nos últimos seis meses:
- Adicionar suporte a GraphRAG (#2837, 31 comentários)
- A página do carregador de documentos fica em branco (#5097, 24 comentários)
- Comportamento da sobreposição no divisor de texto (#5173, 19 comentários)
O Flowise foi arquivado em 13 de agosto de 2026. As issues da amostra incluem suporte a GraphRAG, uma página do carregador de documentos em branco e o comportamento da sobreposição no divisor de texto. GraphRAG é um pedido de melhoria; o carregador em branco é uma falha concreta de usabilidade. Os dois não devem ter o mesmo peso. Implantações existentes com versão fixada podem continuar úteis, mas quem adotar agora não pode contar com correções contínuas do projeto original. Um fork mantido exigiria uma avaliação separada das releases, do backlog e da atividade de suporte dele.
AutoGen: Slop Log Score de 0.6116
Threads abertas mais comentadas nos últimos seis meses:
- Recibos criptográficos de ações para trabalho delegado (#7353, 417 comentários)
- Adicionar um ponto de extensão GuardrailProvider (#7405, 147 comentários)
- Introduzir o papel de guardião da missão (#7487, 74 comentários)
As threads mais comentadas da amostra propõem recibos criptográficos de ações, um hook GuardrailProvider e um papel de guardião da missão. São propostas de governança e arquitetura, não centenas de relatos independentes de falhas. O destaque delas mostra a demanda por uma supervisão mais forte do trabalho delegado. A Microsoft direcionou os novos projetos para o Agent Framework, enquanto o AutoGen é mantido pela comunidade. Ainda assim, quem for adotá-lo deve avaliar o caminho de manutenção atual e os controles de governança disponíveis, em vez de supor que a associação histórica com a Microsoft garante suporte futuro para as suas cargas de trabalho.
Microsoft Agent Framework: Slop Log Score de 0.5437
Threads abertas mais comentadas nos últimos seis meses:
- Fronteiras de identidade e confiança nas passagens entre agentes (#4842, 17 comentários)
- Limitações da DevUI (#2084, 16 comentários)
- Política de aprovação vale, sem que se espere, para todas as funções (#3054, 14 comentários)
As threads da amostra tratam de identidade e confiança nas passagens entre agentes, das limitações da DevUI e de uma política de aprovação que, sem que se espere, passa a valer para todas as funções. A primeira é uma questão de design; o comportamento da aprovação tem impacto operacional mais direto. As duas importam quando agentes especialistas herdam permissões ou aguardam revisão humana. As evidências combinam com um framework em desenvolvimento, com semânticas importantes ainda em discussão. Faça protótipos de propagação de identidade, aprovações seletivas e visibilidade de depuração antes de escolhê-lo para trabalho delegado que atravessa usuários ou fronteiras de permissão.
ZeroClaw: Slop Log Score de 0.5148
Threads abertas mais comentadas nos últimos seis meses:
- A política granular de sandbox diverge das configurações definidas (#6996, 29 comentários)
- RFC de work lanes e automação de quadros (#6808, 24 comentários)
- RFC do protocolo de comunicação com provedores (#8396, 19 comentários)
A issue mais discutida da amostra trata de uma política granular de sandbox que diverge das configurações definidas. A discussão estruturada sobre a política e uma votação aprovada são sinais animadores de engajamento, mas não comprovam, por si sós, uma correção já lançada. Outras threads de destaque são RFCs de work lanes e de protocolos de provedores, que representam recursos planejados, e não falhas confirmadas. Mesmo assim, verifique as restrições efetivas da sandbox com testes negativos antes de confiar nos rótulos de configuração em fluxos de trabalho com consequências reais.
OpenHands: Slop Log Score de 0.4662
Threads abertas mais comentadas nos últimos seis meses:
- O Agent Canvas detecta a porta errada e não consegue se conectar (#17546, 204 comentários)
- Roadmap para paridade de recursos (#9689, 29 comentários)
- O consentimento de analytics reaparece depois de dispensado (#16601, 19 comentários)
A maior thread da amostra descreve o Agent Canvas detectando a porta errada e falhando ao se conectar. Uma correção vinculada e a priorização pelos mantenedores mostram engajamento, embora um patch proposto não comprove que todas as configurações lançadas funcionam. Outras threads tratam de um roadmap de paridade de recursos e do consentimento de analytics que reaparece depois de dispensado. O roadmap não é um defeito; a persistência do consentimento é uma questão concreta de UX. Teste a conectividade do ambiente e a persistência das preferências na sua implantação, e veja se as lacunas não resolvidas do roadmap afetam o trabalho que você espera que os agentes façam.
Pydantic AI: Slop Log Score de 0.4531
Threads abertas mais comentadas nos últimos seis meses:
- Tracker automatizado de execuções de detecção (#5955, 44 comentários)
- Aprovação humana para trabalho multiagente (#3274, 43 comentários)
- O sinal de aprovação é um booleano simples, sem vínculo com a execução (#5536, 35 comentários)
A thread mais comentada da amostra é um tracker automatizado de execuções de detecção, então o volume de comentários ali é uma evidência fraca de falha do produto. As discussões mais significativas tratam de aprovação humana para trabalho multiagente e de um sinal de aprovação representado como um booleano simples, sem vínculo com uma ferramenta, execução, nonce ou prazo de expiração específicos. Esses detalhes determinam se o consentimento pode ser reaproveitado fora do contexto pretendido. Quem desenvolve deve verificar se a aprovação é específica por ação e tem prazo de expiração antes de criar fluxos delegados com consequências reais.
Dify: Slop Log Score de 0.3885
Threads abertas mais comentadas nos últimos seis meses:
- Fail-fast paralelo deixa erros sem atribuição ou desatualizados (#39151, 61 comentários)
- Pedido de comportamento de reescrita de propriedades (#40372, 57 comentários)
- Discussão sobre testes com SQLite e refatoração (#32454, 37 comentários)
A preocupação de confiabilidade mais forte da amostra envolve a execução paralela com fail-fast, que deixa erros sem atribuição ou desatualizados. Um fluxo que para sem identificar com clareza o ramo que falhou dificulta a recuperação e pode levar a novas execuções desnecessárias. Outras discussões de destaque tratam do comportamento de reescrita e de testes ou refatoração com SQLite; são discussões de produto e engenharia, e não evidências diretas de falha em tempo de execução. Na hora de adotar, faça ramos paralelos falharem de propósito e inspecione o trace resultante. Atribuição clara e estado parcial recuperável importam mais para o seu fluxo de trabalho do que o total bruto de issues.
Mastra: Slop Log Score de 0.3948
Threads abertas mais comentadas nos últimos seis meses:
- Suporte a ramificação de mensagens (#5093, 15 comentários)
- UI/schema de suspensão e retomada de ferramentas personalizadas (#20603, 9 comentários)
- Cancelar ou parar um agente pelo Slack (#17065, 8 comentários)
As threads da amostra pedem ramificação de mensagens, interfaces mais claras para suspender e retomar ferramentas personalizadas e cancelamento pelo Slack. Na maior parte, são lacunas de recursos, e não evidências de que a execução atual esteja quebrada. Mesmo assim, elas importam para a delegação na prática: os usuários precisam revisar ações pendentes, retomar com segurança e interromper trabalho incorreto pela interface de mensagens. A adequação depende da experiência de controle de que você precisa. Faça um protótipo do cancelamento pelo Slack e da revisão humana antes de se comprometer com um fluxo compartilhado, principalmente quando quem supervisiona os agentes não é o desenvolvedor.
AutoGPT: Slop Log Score de 0.3913
Threads abertas mais comentadas nos últimos seis meses:
- Limites de delegação aplicáveis para gastos e tempo decorrido (#12700, 21 comentários)
- Adicionar suporte ao modelo Gemini (#6885, 11 comentários)
- Melhorar contêineres e runbooks, incluindo o Coolify (#10948, 10 comentários)
A principal thread da amostra pede limites de delegação aplicáveis para gastos e tempo decorrido. É uma lacuna importante de governança: instruções que pedem a um agente para parar são diferentes de limites impostos em tempo de execução e herdados por agentes filhos. Outras threads pedem suporte ao Gemini e runbooks melhores para contêineres, incluindo o Coolify. São necessidades de integração e implantação, e não prova de que todas as instalações falham. Antes de executá-lo sem supervisão, verifique orçamentos rígidos, herança por agentes filhos, persistência e recuperação em uma implantação em contêiner com versão fixada. Essas verificações tratam dos riscos práticos que a amostra de issues destaca.
Goose: Slop Log Score de 0.3405
Threads abertas mais comentadas nos últimos seis meses:
- Expor recursos A2UI retornados pelo MCP (#12703, 16 comentários)
- Regras granulares de permissão do shell (#11399, 15 comentários)
- Modularidade do GRC (#11253, 14 comentários)
As threads de destaque da amostra tratam da exposição de recursos A2UI vindos do MCP, de regras granulares de permissão do shell e da modularidade do GRC. São discussões de melhoria e arquitetura, não um conjunto de falhas reproduzíveis em tempo de execução. O trabalho de colaboradores em um pull request de A2UI é um sinal positivo de engajamento, embora não comprove um recurso lançado. As permissões do shell merecem atenção especial, porque um acesso amplo a comandos pode ir além do que o usuário pretendia. Confira quais dos controles solicitados já foram lançados e teste as regras de permissão atuais com os comandos que você usa de fato e com as restrições do seu sistema operacional.
Google ADK: Slop Log Score de 0.3695
Threads abertas mais comentadas nos últimos seis meses:
- Adicionar um registro de decisões para as ações dos agentes (#6099, 48 comentários)
- Comportamento de criação automática de schema no banco de dados (#3343, 23 comentários)
- Colisão de chaves de sessão no Redis com tupla de identidade que contém dois-pontos (#7464, 21 comentários)
A thread mais discutida da amostra propõe um registro de decisões, o que destaca a demanda por ações de agentes auditáveis, e não um defeito confirmado. Outras discussões tratam do comportamento de criação automática de schema no banco de dados e de colisões de chaves de sessão no Redis quando componentes da identidade contêm dois-pontos. O relato do Redis é uma questão concreta de correção, porque chaves ambíguas podem misturar identidades de sessão. Teste a codificação de identidades, o comportamento das migrações do banco de dados e o histórico de auditoria retido antes de adotá-lo em fluxos que envolvam várias pessoas ou sessões persistentes.
CrewAI: Slop Log Score de 0.2959
Threads abertas mais comentadas nos últimos seis meses:
- Novas tentativas podem repetir efeitos colaterais de ferramentas externas, como e-mail ou pagamento (#5802, 216 comentários)
- Adicionar middleware de governança para autorização de ferramentas (#5888, 148 comentários)
- Proposta de mediação de controle de releases em tempo de execução (#6025, 127 comentários)
Uma issue séria da amostra relata que novas tentativas podem repetir efeitos colaterais externos, como enviar e-mails ou fazer pagamentos. Se uma ação dá certo, mas a confirmação se perde, tentar de novo sem idempotência pode duplicar a ação. Outras threads muito discutidas propõem middleware de autorização e mediação de controle de releases em tempo de execução. São pedidos de governança, não evidências independentes de travamentos. Verifique a idempotência e o tratamento de sucesso parcial antes de permitir que agentes enviem, paguem, publiquem ou alterem registros importantes sem supervisão.
Agent Zero: Slop Log Score de 0.2106
Threads abertas mais comentadas nos últimos seis meses:
- Dúvida sobre instalação e configuração (#1847, 6 comentários)
- Os dados base64 das imagens crescem até o provedor retornar HTTP 413 (#1857, 4 comentários)
- O salvamento de memória se repete ou é ignorado com Ollama e Qwen (#1967, 4 comentários)
A principal thread da amostra é uma dúvida de configuração com apenas seis comentários, o que diz pouco sobre a confiabilidade geral. Dois relatos menores são mais específicos: os dados de imagem em base64 crescem até um provedor retornar HTTP 413, e o salvamento de memória se repete ou é ignorado com Ollama e Qwen. Eles apontam casos de histórico multimodal e de persistência específica de provedor que vale testar, mas o número de comentários não comprova a frequência desses problemas. Verifique sessões com muitas imagens e a retenção de memória usando a configuração exata do seu modelo local antes de depender de trabalho autônomo de longa duração.
Langflow: Slop Log Score de 0.1491
Threads abertas mais comentadas nos últimos seis meses:
- Fluxo com Celery, RabbitMQ e Redis falha por causa do comportamento do pickle (#8476, 23 comentários)
- Colaboração, papéis, compartilhamento e histórico de versões (#1864, 21 comentários)
- Suporte a um caminho base personalizado (#8503, 15 comentários)
As threads da amostra tratam de uma falha de workers distribuídos envolvendo Celery, RabbitMQ, Redis e o comportamento do pickle, de controles de colaboração e do suporte a caminho base personalizado. A discussão sobre os workers tem um caminho de correção e teste, um sinal animador de manutenção que ainda precisa ser confirmado em uma release. Os pedidos de colaboração são especialmente relevantes para uso compartilhado: papéis, compartilhamento e histórico de versões podem determinar se duas pessoas conseguem gerenciar o trabalho com segurança. Ainda assim, um backlog organizado não comprova que o produto serve para você. Teste contas separadas, permissões de fluxos, execução distribuída e roteamento por proxy no ambiente em que você pretende implantar.
LangGraph: Slop Log Score de 0.1379
Threads abertas mais comentadas nos últimos seis meses:
- Chamadas longas de ferramentas podem ser repetidas a partir do checkpoint enquanto a original ainda está em execução (#7417, 88 comentários)
- Erro de SSL no checkpointer do PostgreSQL (#3716, 53 comentários)
- O cancelamento perde o estado transmitido que ainda não tinha checkpoint (#5672, 52 comentários)
Os relatos da amostra descrevem problemas com consequências reais: chamadas longas de ferramentas podem ser repetidas a partir de checkpoints enquanto a original continua em execução, conexões de checkpoint com o PostgreSQL podem falhar no SSL, e o cancelamento pode perder estado transmitido sem checkpoint. O relato sobre a repetição descreve trabalho e custo duplicados, com risco adicional quando as ferramentas têm efeitos não idempotentes. Essas threads tratam de durabilidade e recuperação, e não de acabamento cosmético. Teste chamadas com mais de três minutos, cancelamentos deliberados e o comportamento de TLS do banco de dados antes de delegar ações importantes aos mecanismos de recuperação do LangGraph.
Letta Code: Slop Log Score de 0.1174
Threads abertas mais comentadas nos últimos seis meses:
- Tracker automatizado de habilidades desatualizadas (#4065, 36 comentários)
- Expor metadados de limite de tokens do BYOK (#3802, 6 comentários)
- A memória fica isolada por agente e não é compartilhada entre novas sessões (#2666, 5 comentários)
A issue mais comentada da amostra é um tracker automatizado de habilidades desatualizadas, então os comentários não devem ser lidos como falhas independentes de usuários. Outras threads pedem metadados de limite de tokens do BYOK e discutem a memória isolada entre agentes ou novas sessões. A questão da memória importa porque os usuários podem esperar uma continuidade que o modelo real de escopo não oferece. Confirme exatamente como a memória persiste e é compartilhada, e verifique como os limites do provedor são informados antes de supor que um agente vai levar decisões de uma sessão de trabalho para outra.
n8n: Slop Log Score de 0.0839
Threads abertas mais comentadas nos últimos seis meses:
- AI Agent/Memory omite mensagens de ferramentas e pode afirmar que uma ferramenta foi usada (#14361, 57 comentários)
- A ferramenta de IA do WhatsApp Business Cloud retorna Invalid URL (#14290, 26 comentários)
- A URL pública do Chat Trigger falha após uma atualização (#28891, 25 comentários)
As issues da amostra ainda apontam falhas práticas: o AI Agent/Memory omite mensagens de ferramentas do seu registro, uma ferramenta do WhatsApp Business Cloud retorna um erro de URL inválida, e uma URL pública do Chat Trigger para de funcionar após uma atualização. Sem o registro das ferramentas, fica difícil auditar o que o agente afirma; falhas em conectores e endpoints podem interromper fluxos que, fora isso, são válidos. Teste os conectores exatos que você usa após as atualizações e garanta que os traces de execução registrem as chamadas reais de ferramentas antes de confiar no relato do assistente sobre o trabalho concluído.
OpenAI Agents SDK: Slop Log Score de 0.0273
Threads abertas mais comentadas nos últimos seis meses:
- A decisão de aprovação pode ser transferida entre execuções quando o ID da chamada é reutilizado (#5413, 6 comentários)
- Problema de tipagem (#5387, 4 comentários)
- Suporte ao Redis Cluster (#5322, 2 comentários)
A fila minúscula é animadora, mas o principal relato da amostra afirma que a aprovação pode ser transferida entre execuções quando o ID de uma chamada de ferramenta é reutilizado. Quem abriu a issue descreve uma reprodução offline no branch main. Isso pode cruzar uma fronteira de autorização: o consentimento deve valer apenas para a ação e o contexto revisados. As threads menores tratam de tipagem e do suporte ao Redis Cluster. A issue mais forte da amostra merece uma verificação direcionada. Reproduza a reutilização do ID de chamada na release que você escolheu e confirme que as aprovações não autorizam ações posteriores indesejadas.
O que o Slop Benchmark mostra no geral
O Hermes Agent tem a maior pontuação deste retrato, 2.3105, seguido pelo Paperclip, com 1.7763. As issues da amostra dos dois incluem discussões de arquitetura e de fluxo de trabalho, ao lado de solicitações de recursos. Na parte de baixo, OpenAI Agents SDK, n8n, Letta Code, LangGraph e Langflow têm pontuações menores, mas as amostras de issues deles ainda incluem comportamentos que vale testar. Uma pontuação sozinha não comprova a confiabilidade de um projeto.
Esse é o papel útil do benchmark: ajudar a encontrar repositórios cujas filas abertas merecem uma inspeção mais cuidadosa. Depois, as issues mostram se você está diante de defeitos, recursos ausentes, ruído automatizado ou trabalho ativo de design. Não é justo dizer que um projeto é “bom” só porque tem muitas releases, ou “ruim” porque tem muitas issues abertas. Se for escolher um framework de agentes para trabalho real, leia as threads de issues que tocam no seu fluxo de trabalho, como permissões, novas tentativas, persistência, chamadas de longa duração e recuperação, e verifique esses comportamentos na release que você pretende executar.